O robots.txt de um publisher está a bloquear o que ninguém auditou
 Por Miguel Maio ·
Num publisher, o robots.txt e a CDN raramente são auditados ao detalhe, e é aí que se perde tráfego, imagens e citações sem ninguém dar conta. A pergunta certa não é "bloquear ou permitir a IA", é "que recurso estou a bloquear, para que bot, e com que efeito no Google News, no Discover e nas respostas de IA". A 15 de setembro a Cloudflare passou a permitir bloquear o treino sem sair da pesquisa - mas só com três fornecedores e com prazo por cumprir.
Num órgão de comunicação, o robots.txt e a configuração da CDN raramente são auditados ao pormenor - e é exatamente aí que se perde tráfego, imagens e citações sem ninguém dar conta. A pergunta "bloquear ou permitir a IA?" é a errada para um publisher. A certa é: que recurso estou a bloquear, para que bot, e com que efeito no Google News, no Discover e nas respostas de IA?
O robots.txt de um publisher não governa "o site"
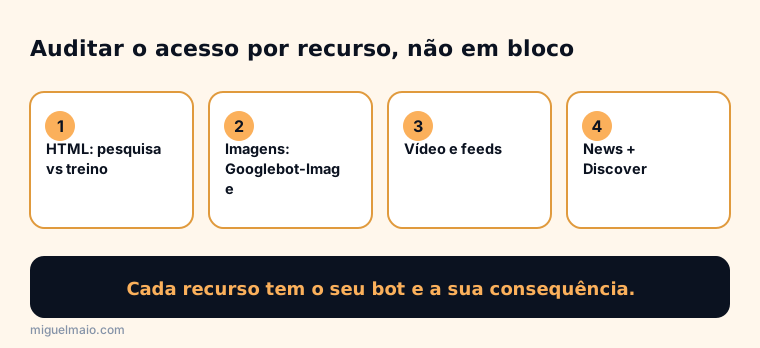
Governa o acesso por tipo de recurso e por bot, e é isso que quase ninguém audita. Num site de conteúdo há, no mínimo, quatro planos diferentes a controlar: o HTML das notícias, as imagens, o vídeo, e os canais que dependem de crawlers próprios ou de elegibilidade própria - o Google News e o Google Discover. Um Disallow: / apontado ao user-agent errado não "protege o site": apaga um canal inteiro, e o efeito só aparece semanas depois, no tráfego.
O que audito, recurso a recurso
Quando entro num publisher, a auditoria de acesso não é uma leitura do robots.txt de cima a baixo - é uma verificação de cada tipo de recurso contra o bot que o serve e o canal que dele depende. É por aqui que passo:
- HTML: separar pesquisa de treino. O Googlebot serve a Pesquisa e o Discover; o Google-Extended controla o uso do conteúdo para treino do Gemini sem afetar ranking. Bloquear o Googlebot tira o site do Google; bloquear só o Google-Extended, não.
- Imagens: o Googlebot-Image tem user-agent próprio. Bloqueá-lo tira as fotos do Google Imagens e enfraquece os cartões ricos e o Discover, que é muito visual. Num publisher, as imagens são tráfego, não decoração.
- Vídeo: confirmar que o vídeo e os seus metadados (thumbnails, transcrições) não estão atrás de um bloqueio herdado de um CMS antigo.
- News e Discover: ambos dependem de o conteúdo ser rastreável e indexável. Não há um interruptor mágico - há a ausência de bloqueios acidentais e a elegibilidade técnica (dados estruturados, imagens grandes, políticas editoriais).
- Bots de IA, um a um: o GPTBot (treino da OpenAI) e o OAI-SearchBot (citações em tempo real no ChatGPT) são bots diferentes, com consequências diferentes. O mesmo vale para o PerplexityBot. Bloquear o treino não é o mesmo que bloquear a citação - e trocar os dois é o erro clássico.
- CDN e rate limits: um 429 demasiado apertado ou uma regra de WAF corta bots legítimos com permissão no robots.txt. O ficheiro diz "entra"; a CDN diz "não". Audito sempre os dois.
O erro que apanho mais vezes
O padrão repete-se: um publisher quis "bloquear a IA" e, sem saber, deitou-se fora das citações que lhe traziam tráfego. Já encontrei um Disallow: / para o OAI-SearchBot posto para "não alimentar a OpenAI" - só que o OAI-SearchBot não treina nada, serve as citações do ChatGPT em tempo real. O publisher continuou a ser treinado por outros bots e deixou de ser citado onde queria estar. Noutro caso, um bloqueio total ao Googlebot-Image, herdado de uma migração, tinha as fotos fora do Google Imagens há meses, com perda direta no Discover. Nenhum destes aparece no ranking clássico - por isso ninguém liga os pontos até alguém auditar.
O que a Cloudflare mudou a 15 de setembro - e o que não resolve
Até agora, bloquear o treino de IA sem perder a pesquisa era difícil na prática: os controlos eram, na maioria, tudo-ou-nada. A 15 de setembro de 2026, a Cloudflare lançou a opção "Disallow AI Training", que mantém o crawler para pesquisa e bloqueia o mesmo crawler para treino. Passa a distinguir três comportamentos de bot - pesquisa, treino e agente - e chama "accountable" a quem cumpre quatro condições, incluindo a garantia de que sair do treino não afeta os resultados de pesquisa clássicos. É gerido por um novo "Bot Preference Sync", que substitui o antigo Managed Robots.txt.
O que não resolve, e é preciso dizê-lo: só a Apple, a Google e a Microsoft estão designadas como "accountable", e comprometeram-se a cumprir num prazo definido - ou seja, nem todas aplicam já. Todos os outros crawlers de treino continuam no bloqueio total. E a Cloudflare é um intermediário, não uma norma da web: isto vale para quem está atrás da Cloudflare e enquanto estes fornecedores respeitarem o compromisso. É um avanço real, não uma solução universal.
Como decidir, por recurso e não em bloco
A decisão certa num publisher não é uma linha no robots.txt - é uma matriz. Para cada recurso (HTML, imagens, vídeo) e cada canal (Pesquisa, News, Discover, citações de IA, treino de IA), a pergunta é a mesma: isto traz-me tráfego ou autoridade, ou só me alimenta um modelo sem retorno? O treino de modelos é, para a maioria dos publishers, o único candidato honesto a bloqueio - e agora dá para o bloquear sem sacrificar a pesquisa, ao menos com três fornecedores. Tudo o resto - pesquisa, imagens, News, Discover, citação em tempo real - é visibilidade que se abdica a troco de nada.
Um publisher que trate isto por reflexo - "a IA rouba-nos, bloqueia tudo" - não protege o conteúdo; corta os canais que ainda lhe trazem leitores. O custo não aparece no ranking, aparece no tráfego, três meses depois, quando já ninguém se lembra da linha que se mudou no robots.txt.
Fontes
- Cloudflare - Have it both ways: stay discoverable while disallowing AI training
- Google Search Central - Visão geral dos crawlers da Google (user-agents)
- OpenAI - GPTBot e OAI-SearchBot
Perguntas frequentes
Bloquear o GPTBot tira-me do Google?
Não. O GPTBot é o crawler de treino da OpenAI; não tem qualquer efeito no Google. Também não te tira das citações do ChatGPT em tempo real, que dependem do OAI-SearchBot - são bots diferentes. Bloquear ou permitir a IA →
O Google-Extended afeta o Google News ou o Discover?
Não. A Google afirma que o Google-Extended controla o uso do conteúdo para treinar o Gemini e não afeta a inclusão nem o ranking na Pesquisa, onde se inclui o Discover. Podes bloquear o treino e continuar no News e no Discover. Medir o tráfego de IA →
A opção da Cloudflare resolve o problema de vez?
Não. Resolve a dicotomia treino-vs-pesquisa para quem está atrás da Cloudflare e só com a Apple, a Google e a Microsoft, que se comprometeram num prazo. Os restantes crawlers de treino continuam no tudo-ou-nada.